
 هوش مصنوعی سازمانی فرزان
 مدل زبانی بزرگ (LLM) دانشیار
 آرشیو و مدیریت اسناد سگالسان
 نرم افزار OCR فارسی واژهشناس
 مدیریت هویت و دسترسی پاسار
 نرم افزار تشخیص چهره
 نرم افزار تشخیص عنبیه
 نرم افزار تشخیص اثر انگشت
 نرم افزار حضور و غیاب
 ساخت نرم افزار اختصاصی
 ثبت درخواست نرمافزار
OCR چیست و بهترین نرمافزار OCR فارسی را چطور انتخاب کنیم؟
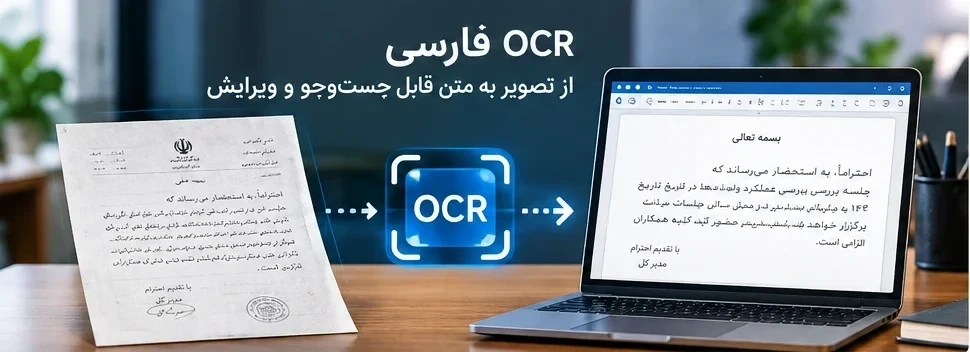
OCR چیست و OCR فارسی چه میکند؟
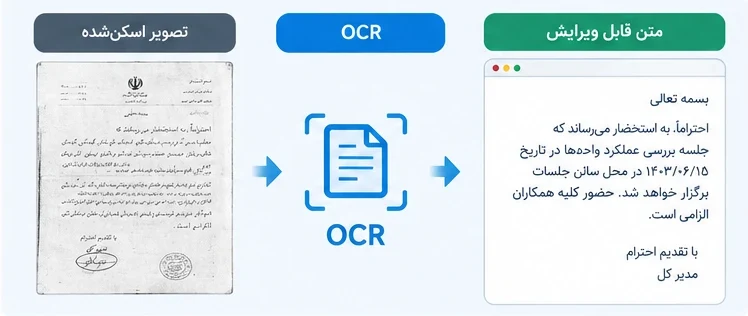
OCR مخفف Optical Character Recognition است؛ یعنی تبدیل تصویر متن تایپی، چاپی یا دستنویس به متنی که رایانه میفهمد. نتیجه، متنی است که میتوانید در آن جستوجو کنید، آن را ویرایش کنید یا به نرمافزارهای دیگر بدهید.
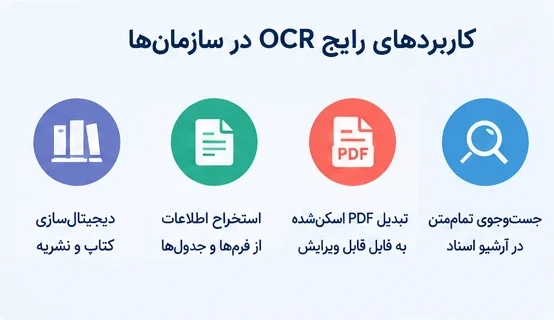
کاربردهای رایج در سازمانها:
- جستوجوی تماممتن در آرشیو نامهها و قراردادهای اسکنشده
- تبدیل PDF اسکنشده به فایل قابل ویرایش
- استخراج اطلاعات از فرمها و جدولها
- دیجیتالسازی کتاب، نشریه و اسناد قدیمی
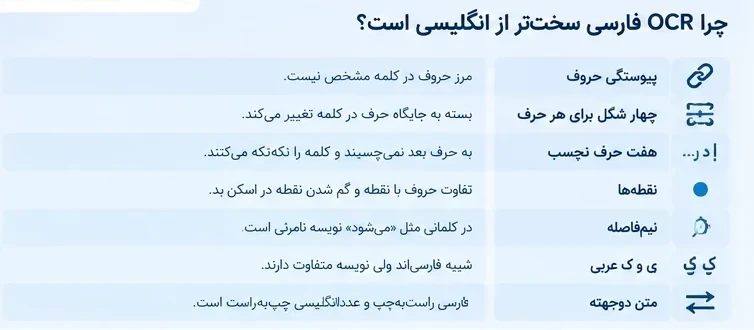
چرا OCR فارسی سختتر از انگلیسی است؟
خط فارسی ویژگیهایی دارد که خواندن آن را برای ماشین سختتر میکند. نرمافزاری که برای فارسی ساخته نشده، معمولاً در همین نقاط خطا میکند:
| ویژگی خط فارسی | چرا مشکل است | نرمافزار خوب چه باید بکند |
|---|---|---|
| پیوستگی حروف | بیشتر حروف یک کلمه به هم میچسبند و مرز حرفها روشن نیست. | کلمه را یکجا و با کمک بافت (Context) بخواند، نه حرفبهحرف. |
| چهار شکل برای هر حرف | شکل حرف بسته به جایش عوض میشود: تنها، ابتدا، میانه و انتهای کلمه. | روی همه شکلها آموزش دیده باشد. |
| هفت حرف ناچسب | حروفی مثل «ا، د، ذ، ر، ز، ژ، و» به حرف بعد نمیچسبند و کلمه را تکهتکه نشان میدهند. | فاصله داخل کلمه را با فاصله بین دو کلمه اشتباه نگیرد. |
| نقطهها | بسیاری از حروف فقط با تعداد و جای نقطه فرق دارند (ب، پ، ت، ث). نقطه کوچک در اسکن بد گم میشود. | پیشپردازش تصویر و تصحیح بر اساس واژهنامه. |
| نیمفاصله | در کلماتی مثل «میشود» یا «سازمانها» نویسه نامرئی نیمفاصله لازم است. | نیمفاصله را درست بازسازی کند تا جستوجو کار کند. |
| ی و ک عربی | «ي» و «ك» عربی در ظاهر شبیه «ی» و «ک» فارسیاند ولی نویسه دیگری هستند. | خروجی را به نویسه استاندارد فارسی یکسان کند؛ وگرنه جستوجوی «کتاب» نسخه «كتاب» را پیدا نمیکند. |
| متن دوجهته | فارسی راستبهچپ است، ولی عدد و کلمات انگلیسی چپبهراست. | ترتیب درست متن مخلوط را حفظ کند. |
چکلیست انتخاب بهترین نرمافزار OCR فارسی
«بهترین» نرمافزار برای هر سازمان فرق میکند. این هشت معیار را برای هر گزینه بررسی کنید:
| معیار | سؤالی که باید بپرسید |
|---|---|
| ۱. دقت روی اسناد خودتان | روی نمونه اسناد واقعی شما، نرخ خطای نویسه و کلمه چقدر است؟ (روش سنجش پایین آمده) |
| ۲. ساختار سند | جدول، ستونبندی و ترتیب خواندن صفحه را حفظ میکند یا فقط متن خام میدهد؟ |
| ۳. دستنویس و اسناد قدیمی | اگر چنین اسنادی دارید، آیا قابل آموزش با نمونههای شماست؟ |
| ۴. خروجی | PDF قابل جستوجو، Word، متن ساده یا JSON برای نرمافزارهای دیگر میدهد؟ |
| ۵. امنیت داده | اسناد شما به سرور بیرونی ارسال میشود یا روی سرور خود سازمان (خودمیزبان) پردازش میشود؟ |
| ۶. حجم کار | پردازش دستهای و API برای اتصال به آرشیو و اتوماسیون دارد؟ |
| ۷. یکسانسازی نویسهها | ی و ک عربی، نیمفاصله و ارقام را در خروجی درست و یکسان میکند؟ |
| ۸. پشتیبانی | پشتیبانی فارسی، بهروزرسانی و امکان تنظیم برای اسناد خاص شما وجود دارد؟ |
چطور دقت OCR را خودتان بسنجید؟
- نمونه انتخاب کنید: ۳۰ تا ۵۰ صفحه از اسناد واقعی، شامل بدترینها: اسکن کج، کمرنگ، جدولدار و مهرخورده.
- متن درست را آماده کنید: متن چند صفحه را دستی و بیغلط تایپ کنید (متن مرجع).
- خروجی هر نرمافزار را مقایسه کنید و نرخ خطای کلمه (WER) را حساب کنید:
S تعداد کلمات جابهجا خواندهشده، D کلمات جاافتاده، I کلمات اضافه و N تعداد کلمات متن مرجع است. نرخ خطای نویسه (CER) همین محاسبه در سطح حرف است. عدد کمتر یعنی دقت بیشتر.
دو نکته: به عدد دقت تبلیغاتی بدون نوع سند اعتماد نکنید، و نتیجه هر نرمافزار را روی همان نمونههای یکسان مقایسه کنید.
نکات اسکن برای نتیجه بهتر
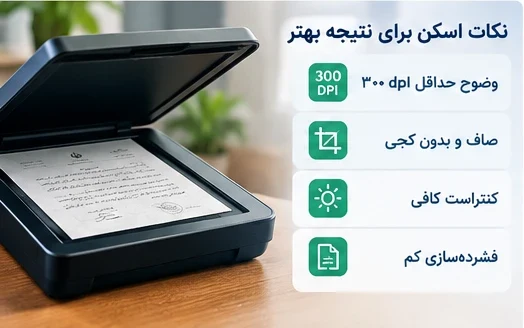
- وضوح دستکم ۳۰۰ dpi: مستندات یکی از رایجترین موتورهای متنباز OCR میگوید بهترین نتیجه روی تصویر با وضوح دستکم ۳۰۰ dpi بهدست میآید.
- صاف و بدون کجی: سند را صاف روی اسکنر بگذارید یا از اصلاح خودکار کجی استفاده کنید.
- کنتراست کافی: متن تیره روی زمینه روشن؛ سایه و لکه را تا حد ممکن کم کنید.
- فشردهسازی کم: فایل JPEG بسیار فشرده، لبه حروف و نقطهها را خراب میکند.
OCR رایگان آنلاین یا نرمافزار سازمانی؟
ابزارهای رایگان آنلاین برای چند صفحه شخصی مفیدند. برای سازمان، سه پرسش را بپرسید: آیا ارسال اسناد محرمانه به سرور دیگران مجاز است؟ حجم روزانه شما چقدر است؟ آیا خروجی باید مستقیم وارد آرشیو یا سامانه دیگری شود؟ اگر جواب یکی از اینها مهم است، نسخه خودمیزبان سازمانی انتخاب منطقیتری است.
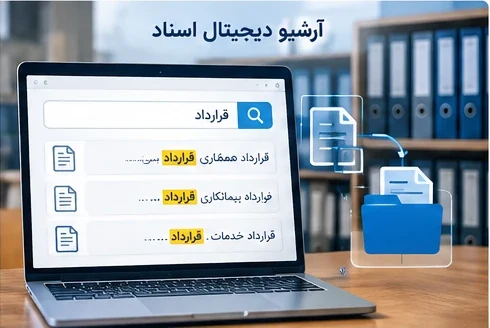
واژهشناس؛ نرم افزار OCR فارسی هوش مصنوعی رایورز
واژهشناس روی سرور سازمان شما نصب میشود، متن چاپی و دستنویس فارسی را میخواند، جدول و ساختار صفحه را حفظ میکند و خروجی آن مستقیم وارد آرشیو میشود.
پرسشهای متداول
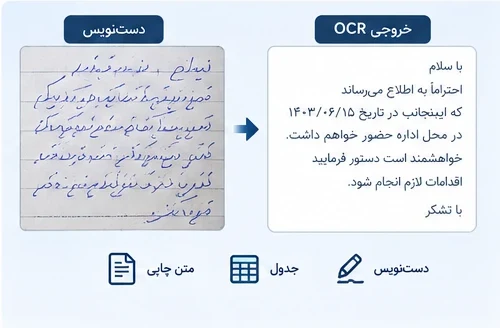
آیا OCR فارسی میتواند دستنویس را بخواند؟
بله، ولی دقت آن به خط نویسنده و کیفیت تصویر بستگی دارد و معمولاً کمتر از متن چاپی است. نرمافزارهایی که با نمونه دستنویسهای خود سازمان آموزش میبینند، نتیجه بهتری میدهند.
آیا OCR جدول را هم تشخیص میدهد؟
نرمافزارهایی که تحلیل ساختار سند دارند، سطر و ستون جدول را جدا میکنند. ابزارهای ساده فقط متن را پشت سر هم میدهند.
چرا در متن خروجی، جستوجو برخی کلمات را پیدا نمیکند؟
معمولاً بهخاطر ی و ک عربی یا نبودن نیمفاصله است. نرمافزار خوب این نویسهها را در خروجی یکسان میکند.
OCR را کجا در سازمان به کار ببریم؟
بیشترین بازده در آرشیو اسناد و دبیرخانه است. برای آشنایی بیشتر، راهنمای نرم افزار مدیریت اسناد سازمانی و نرم افزار آرشیو اسناد سگالسان را ببینید.
منابع
- Persian alphabet، ویکیپدیا: ۳۲ حرف، پیوستگی و چهار شکل حروف، هفت حرف ناچسب، نیمفاصله، تفاوت ی فارسی و عربی، نقطهها.
- Optical character recognition، ویکیپدیا: تعریف OCR و نقش بافت و واژهنامه در خواندن خط پیوسته.
- Word error rate، ویکیپدیا: فرمول WER.
- Improving the quality of the output (tessdoc): توصیه وضوح دستکم ۳۰۰ dpi و اثر نویز و کجی بر دقت.
بدون دیدگاه