
 هوش مصنوعی سازمانی فرزان
 مدل زبانی بزرگ (LLM) دانشیار
 آرشیو و مدیریت اسناد سگالسان
 نرم افزار OCR فارسی واژهشناس
 مدیریت هویت و دسترسی پاسار
 نرم افزار تشخیص چهره
 نرم افزار تشخیص عنبیه
 نرم افزار تشخیص اثر انگشت
 نرم افزار حضور و غیاب
 ساخت نرم افزار اختصاصی
 ثبت درخواست نرمافزار
راهاندازی هوش مصنوعی سازمانی؛ نقشه راه ۶ گامی از ارزیابی تا بهرهبرداری
چطور یک دستیار هوشمند را روی زیرساخت سازمان مستقر کنیم که از اسناد داخلی، با ذکر منبع و بدون خروج داده پاسخ بدهد؛ همراه با چکلیست آمادگی، عوامل هزینه و سنجههای موفقیت.
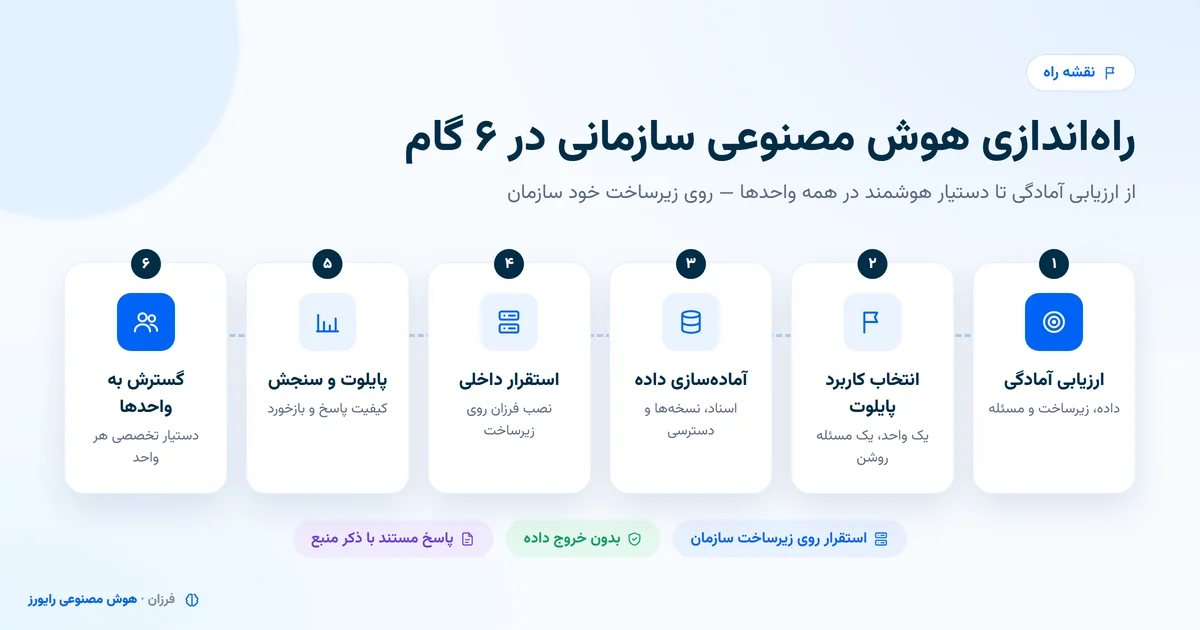
راهاندازی هوش مصنوعی سازمانی یعنی یک دستیار هوشمند را روی زیرساخت خود سازمان مستقر کنید، آن را به اسناد و سامانههای موجود وصل کنید و به کارکنان اجازه دهید سؤالشان را به فارسی بپرسند و پاسخ را همراه با منبع بگیرند. مسیر درست شش گام دارد: ارزیابی آمادگی، انتخاب یک کاربرد پایلوت، آمادهسازی داده و سطح دسترسی، استقرار داخلی، پایلوت و سنجش، و در پایان گسترش به واحدهای دیگر. بیشترین ریسک پروژه در فناوری نیست؛ در داده نامرتب و نبود معیار موفقیت است.
هوش مصنوعی سازمانی دقیقاً چه چیزی را راهاندازی میکند؟
وقتی از هوش مصنوعی سازمانی حرف میزنیم، منظور یک اپلیکیشن گفتگوی عمومی نیست که کارمندان در مرورگر باز کنند. منظور سامانهای است که دانش خود سازمان را میشناسد: آییننامهها، قراردادها، مکاتبات، گزارشهای پروژه و داده سامانههای عملیاتی. کارمند میپرسد «سقف اختیار امضای مدیر منطقه چقدر است؟» و پاسخ را از نسخه معتبر همان آییننامه، با ذکر سند و صفحه، میگیرد.
یک پلتفرم هوش مصنوعی سازمانی معمولاً از چهار لایه ساخته میشود و راهاندازی یعنی برپا کردن همین چهار لایه روی زیرساخت سازمان:
اتصال به منابع
اتصالدهندههایی که محتوای اتوماسیون اداری، آرشیو اسناد، ایمیل و فایلسرور را همراه با سطح دسترسی هر سند میخوانند.
جستجو و بازیابی
نمایهسازی معنایی و کلیدواژهای، تا سند مرتبط حتی با واژگان متفاوت پیدا شود؛ همان معماریای که به آن RAG میگویند.
مدل زبانی
مدلی که از دل قطعات بازیابیشده پاسخ فارسی روان مینویسد؛ مثل مدل زبانی بزرگ دانشیار که روی سرور سازمان اجرا میشود.
دستیارهای تخصصی
دستیار حقوقی، مالی یا منابع انسانی؛ هرکدام با دستورالعمل، دامنه دانش و مجوزهای مخصوص خودش.
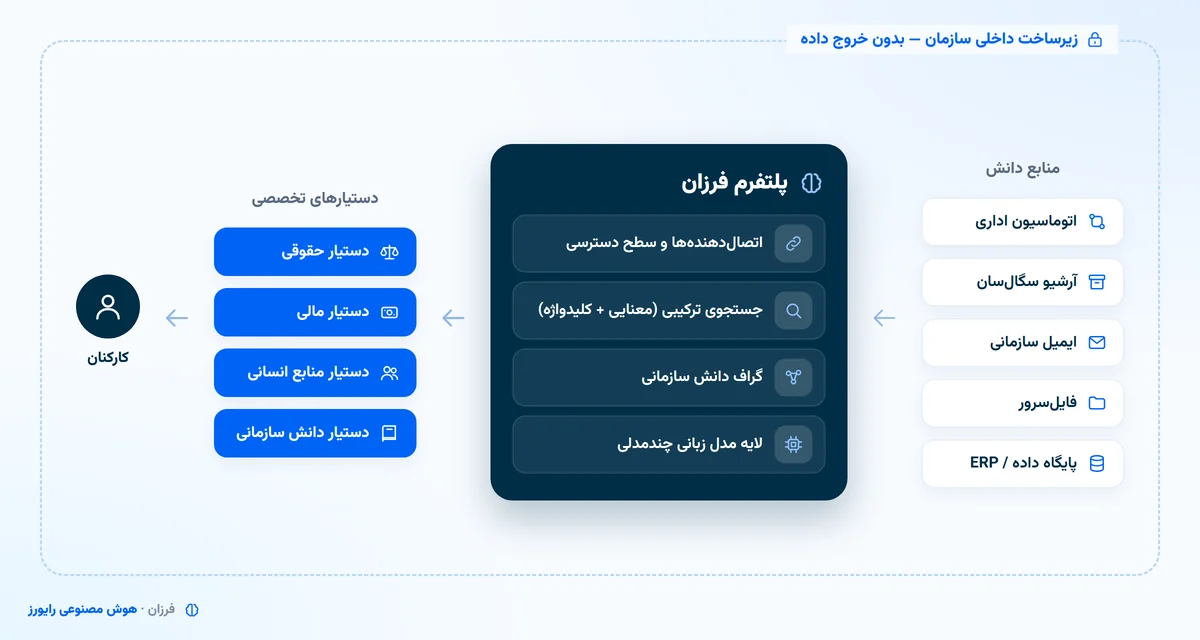
در فرزان، پلتفرم هوش مصنوعی سازمانی رایورز، این لایهها از پیش ساخته شدهاند: بیش از ۴۵ اتصالدهنده آماده، جستجوی ترکیبی معنایی و کلیدواژهای، گراف دانش سازمانی و لایه چندمدلی که به یک ارائهدهنده مدل وابسته نیست. بنابراین بخش بزرگ پروژه، «ساختن» نیست؛ «پیکربندی درست روی داده سازمان» است.
پیش از شروع: آمادگی سازمان را بسنجید
بیشتر پروژههایی که به نتیجه نمیرسند، از همان روز اول آماده نبودهاند. پیش از هر خرید یا نصب، به شش پرسش زیر پاسخ روشن بدهید. لازم نیست همه پاسخها مثبت باشد؛ کافی است بدانید کدام بخش کار در گام آمادهسازی باید انجام شود.
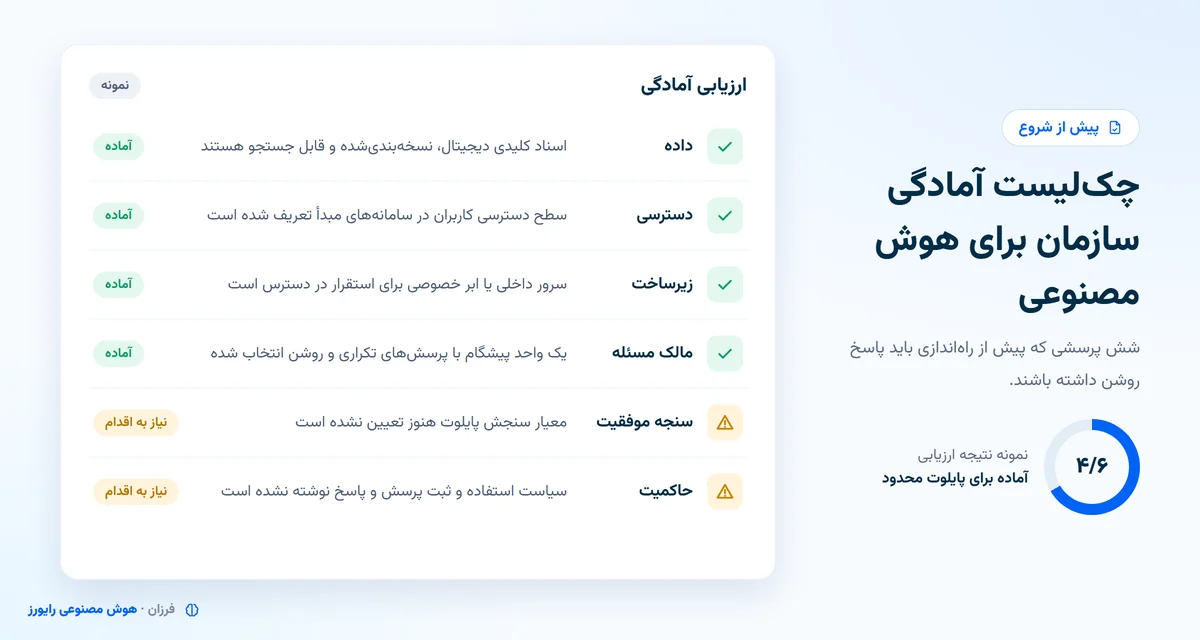
| بعد آمادگی | پرسش کلیدی | اگر پاسخ منفی است |
|---|---|---|
| داده | اسناد کلیدی دیجیتال، نسخهبندیشده و قابل جستجو هستند؟ | ابتدا آرشیو را ساماندهی کنید؛ اسناد کاغذی با OCR فارسی به متن تبدیل میشوند. |
| دسترسی | معلوم است چه کسی مجاز به دیدن چه سندی است؟ | سطوح دسترسی را در سامانه مبدأ یا با مدیریت هویت متمرکز پاسار تعریف کنید. |
| زیرساخت | سرور داخلی یا ابر خصوصی برای استقرار در دسترس است؟ | برآورد سختافزار را در فاز ارزیابی انجام دهید. |
| مالک مسئله | واحدی هست که مسئله روشن و پرسشهای تکراری داشته باشد؟ | پروژه را بدون مالک کسبوکار شروع نکنید. |
| سنجه موفقیت | میدانید پایلوت را با چه عددی موفق یا ناموفق مینامید؟ | پیش از استقرار، سنجهها را بنویسید. |
| حاکمیت | سیاست استفاده، ثبت پرسش و پاسخ و مسئول بازبینی تعیین شده؟ | یک تیم کوچک حاکمیت هوش مصنوعی تشکیل دهید. |
نقشه راه ۶ گامی پیادهسازی هوش مصنوعی در سازمان
این ترتیب از تجربه پروژههای سازمانی آمده است: هر گام خروجی مشخصی دارد که ورودی گام بعد است. پریدن از یک گام، معمولاً یعنی برگشتن به آن چند ماه بعد.
ارزیابی آمادگی و تعریف مسئله
شش بعد بالا بررسی میشود و یک مسئله مشخص انتخاب میگردد؛ مثلاً «کارشناسان حقوقی برای یافتن بند مشابه در قراردادهای گذشته وقت زیادی صرف میکنند». خروجی: سند دامنه پروژه و فهرست منابع داده.
انتخاب کاربرد پایلوت
یک واحد، یک حوزه دانشی و یک گروه کاربر محدود. کاربرد خوب برای شروع، پرسشهای تکراری دارد، منبع پاسخش مکتوب است و خطای آن قابل تشخیص است. خروجی: سناریوهای پرسش و پاسخ واقعی.
آمادهسازی داده و سطح دسترسی
نسخههای منسوخ کنار گذاشته میشوند، اسناد اسکنشده به متن تبدیل میشوند و هر سند تاریخ اعتبار و سطح محرمانگی میگیرد. کیفیت پاسخ هوش مصنوعی مستقیماً تابع کیفیت همین مرحله است.
استقرار داخلی و اتصال به منابع
فرزان روی سرور داخلی یا ابر خصوصی سازمان نصب میشود، به منابع منتخب وصل میگردد و سطح دسترسی هر سند از سامانه مبدأ همگامسازی میشود. ورود کاربران از طریق سامانه احراز هویت سازمان (OIDC یا SAML) انجام میشود.
پایلوت، آزمون و سنجش
دستیار با مجموعهای از پرسشهای واقعی آزموده میشود، کاربران پایلوت چند هفته با آن کار میکنند و پاسخهای نادرست، اسناد مبهم و پرسشهای بیپاسخ ثبت و اصلاح میشوند.
گسترش به واحدهای دیگر
پس از رسیدن به سنجههای پایلوت، حوزههای دانشی و دستیارهای تخصصی جدید روی همان زیرساخت اضافه میشوند؛ از چت بات حقوقی تا دستیار منابع انسانی.
نخستین کاربرد را چطور انتخاب کنیم؟
کاربرد اول باید زود ارزش نشان دهد و ریسک کمی داشته باشد. سه معیار ساده کمک میکند: حجم پرسش تکراری بالا باشد، منبع پاسخ مکتوب باشد و خطا قابل تشخیص باشد. جدول زیر نقطه شروع رایج را در چند واحد نشان میدهد.
| واحد | کاربرد پایلوت | منبع دانش |
|---|---|---|
| حقوقی | جستجوی بند مشابه در قراردادهای گذشته | آرشیو قراردادها و الحاقیهها |
| منابع انسانی | پاسخ به پرسش کارکنان درباره مرخصی و مزایا | آییننامههای استخدامی و رفاهی |
| فناوری اطلاعات | پاسخ اولیه به درخواستهای تکراری کاربران | مستندات فنی و سوابق تیکتها |
| مالی | یافتن مصوبات و رویههای پرداخت | دستورالعملهای مالی و صورتجلسات |
| کل سازمان | پرسش و پاسخ از بخشنامهها و دستورالعملها | آرشیو اسناد سازمان |
اگر آرشیو اسناد سازمان روی نرمافزار آرشیو و مدیریت اسناد سگالسان باشد، کاربرد «پرسش و پاسخ از اسناد» معمولاً سریعترین شروع است، چون داده از پیش طبقهبندی و سطحبندی شده است. توضیح کامل این کاربرد را در صفحه چت بات دانش سازمانی ببینید.
زیرساخت و مدل استقرار
برای سازمانهای ایرانی، پرسش «داده کجا پردازش میشود؟» معمولاً پیش از هر پرسش دیگری مطرح میشود. فرزان سه مدل استقرار دارد: ابر خصوصی سازمان، سرور داخلی، و شبکه کاملاً ایزوله (Air-Gapped) که در آن هیچ اتصالی به اینترنت وجود ندارد. در هر سه مدل، اسناد، نمایهها و گفتگوها داخل زیرساخت سازمان میمانند.
اندازه سختافزار به چهار عامل بستگی دارد: اندازه مدل زبانی، تعداد کاربران همزمان، حجم اسنادی که نمایه میشوند و سرعت پاسخ مورد انتظار. جزئیات این انتخابها را در مقاله هوش مصنوعی سازمانی بدون اینترنت توضیح دادهایم.
هزینه راه اندازی هوش مصنوعی سازمانی به چه عواملی بستگی دارد؟
عدد ثابتی برای قیمت هوش مصنوعی سازمانی وجود ندارد و هر عددی که بدون شناخت داده و زیرساخت شما گفته شود، قابل اتکا نیست. آنچه هزینه را تعیین میکند، روشن است:
- زیرساخت پردازشی: سرور پردازش گرافیکی (GPU)، حافظه و فضای ذخیرهسازی؛ یا استفاده از زیرساخت موجود سازمان.
- دامنه و تعداد کاربران: قیمتگذاری فرزان به امکانات انتخابی و تعداد کاربران وابسته است.
- تعداد و نوع اتصالها: اتصالدهندههای آماده سریعاند؛ اتصال به سامانه سفارشی یا پایگاهداده اختصاصی زمان بیشتری میبرد.
- آمادهسازی داده: اسکن و OCR آرشیو کاغذی، پاکسازی نسخهها و تعریف سطح دسترسی.
- دستیارهای تخصصی: هر دستیار نیازمند تعریف دامنه، دستورالعمل و آزمون جداگانه است.
- آموزش و پشتیبانی: آموزش کاربران، تیم فناوری اطلاعات و پشتیبانی پس از استقرار.
یک مزیت مهم برای سازمانهای ایرانی: قرارداد فرزان داخلی و ریالی است؛ اشتراک ماهانه ارزی ندارد و ریسک قطع سرویس خارجی هم ندارد.
سنجش موفقیت: چه چیزی را اندازه بگیریم؟
پیش از شروع پایلوت، سنجهها را بنویسید و وضعیت فعلی را ثبت کنید؛ وگرنه در پایان پایلوت فقط «احساس» دارید، نه نتیجه. سنجههای پیشنهادی:
دقت پاسخ
درصد پاسخهایی که کارشناس حوزه درست و کامل ارزیابی میکند.
ارجاع درست
آیا سند و بندی که پاسخ به آن ارجاع داده، واقعاً پاسخ را پشتیبانی میکند؟
زمان یافتن پاسخ
زمان رسیدن به پاسخ، پیش و پس از استقرار، برای پرسشهای مشابه.
نرخ استفاده
تعداد کاربران فعال هفتگی و تعداد پرسشها؛ نشانه اعتماد کاربران.
پرسش بیپاسخ
پرسشهایی که پاسخشان در اسناد نبود؛ فهرست دقیق شکاف دانش سازمان.
بار کارشناسان
کاهش پرسشهای تکراری که پیشتر مستقیماً از کارشناسان پرسیده میشد.
اشتباهات رایج در پیاده سازی هوش مصنوعی در سازمان
- شروع با همه سازمان: دامنه بزرگ یعنی داده نامرتب بیشتر و بازخورد کمتر. با یک واحد شروع کنید.
- بارگذاری همه نسخهها: اگر نسخه منسوخ آییننامه در مخزن باشد، دیر یا زود پاسخی بر پایه آن تولید میشود.
- نادیده گرفتن سطح دسترسی: دستیاری که سند محرمانه را به همه نشان دهد، در اولین هفته متوقف میشود.
- پذیرفتن پاسخ بدون منبع: در محیط سازمانی، پاسخ بدون ارجاع قابل اتکا نیست؛ ارجاع به منبع باید پیشفرض باشد.
- استفاده از ابزار عمومی برای داده حساس: ارسال اسناد داخلی به سرویسهای خارجی، ریسک نشت داده دارد. مقایسه کامل را در مقاله ChatGPT سازمانی یا هوش مصنوعی سازمانی داخلی بخوانید.
- رها کردن پس از استقرار: دانش سازمان تغییر میکند؛ همگامسازی، بازبینی پاسخها و آموزش کاربران باید ادامه داشته باشد.
راهاندازی هوش مصنوعی سازمانی با فرزان
هوش مصنوعی رایورز فرزان را بهطور اختصاصی برای هر سازمان راهاندازی میکند: استقرار در زیرساخت سازمان، اتصال به منابع داده، پیکربندی دستیارهای تخصصی و آموزش کاربران، همگی با پشتیبانی فارسی تیم داخلی. فرزان محصول جدید هوش مصنوعی رایورز است، اما بر بیش از دو دهه تجربه نرمافزار سازمانی، آرشیو اسناد و پردازش متن فارسی تکیه دارد.
اگر هنوز درباره مفهوم کلی مطمئن نیستید، راهنمای جامع هوش مصنوعی سازمانی و چتبات تخصصی نقطه شروع خوبی است. برای سازمانهای دولتی هم ملاحظات ویژهای را در مقاله هوش مصنوعی در سازمانهای دولتی جمع کردهایم.
پرسشهای متداول درباره راه اندازی هوش مصنوعی سازمانی
راه اندازی هوش مصنوعی سازمانی از کجا شروع میشود؟
از ارزیابی آمادگی و انتخاب یک مسئله مشخص. پیش از خرید یا نصب، وضعیت داده، سطح دسترسی، زیرساخت، مالک مسئله، سنجه موفقیت و حاکمیت را بسنجید و یک کاربرد پایلوت محدود انتخاب کنید.
پیاده سازی هوش مصنوعی در سازمان چقدر زمان میبرد؟
به آمادگی داده و تعداد اتصالها بستگی دارد. راهاندازی اولیه فرزان معمولاً در مقیاس چند هفته انجام میشود؛ زمانی که صرف ساماندهی آرشیو و تعریف سطح دسترسی میشود، بخش اصلی این زمان است.
آیا برای راهاندازی، دادهها باید از سازمان خارج شوند؟
خیر. فرزان روی ابر خصوصی، سرور داخلی یا شبکه کاملاً ایزوله سازمان مستقر میشود و اسناد، نمایهها و گفتگوها داخل زیرساخت سازمان میمانند.
هزینه هوش مصنوعی سازمانی چقدر است؟
عدد ثابتی وجود ندارد. هزینه به زیرساخت پردازشی، تعداد کاربران، امکانات انتخابی، تعداد اتصالها و حجم آمادهسازی داده بستگی دارد. قرارداد فرزان ریالی است و اشتراک ارزی ندارد.
آیا اسناد سازمان برای آموزش مدل زبانی استفاده میشود؟
در معماری بازیابیمحور (RAG)، اسناد نمایهسازی میشوند و در لحظه پرسش بازیابی میگردند؛ لازم نیست مدل زبانی روی اسناد شما آموزش ببیند.
بهترین کاربرد برای شروع کدام است؟
کاربردی که پرسش تکراری زیاد، منبع پاسخ مکتوب و خطای قابل تشخیص دارد؛ مثل پرسش و پاسخ از آییننامهها، جستجو در قراردادها یا پاسخ به پرسشهای منابع انسانی.
فرزان را روی اسناد سازمان خودتان ببینید
در جلسه دمو، فرزان را روی نمونهای از اسناد واقعی سازمان شما اجرا میکنیم تا کیفیت پاسخ، ارجاع به منبع و رعایت سطح دسترسی را با پرسشهای خودتان بسنجید.